FinOps para IA: cómo controlar el gasto en tokens de tus agentes
El gasto en tokens es ya una partida de P&L. Esta guía detalla cómo aplicar FinOps para IA, controlar costes mediante el RAO y escalar agentes sin comprometer el presupuesto.
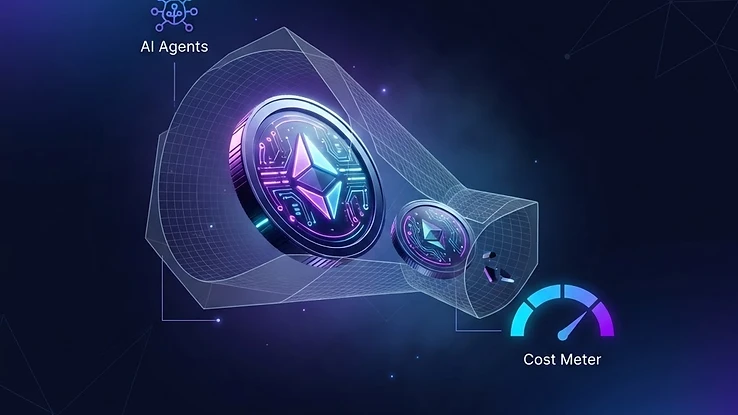

Cada consulta a un LLM tiene un coste directo. Un contexto mal filtrado, reintentos redundantes o agentes que despliegan todo el peso del modelo ante consultas sencillas son fugas de capital constantes. Si esta partida no figura aún como un epígrafe independiente en su P&L, es simple descuido contable. Los datos de Modern Data 101 de julio de 2026 son rotundos: la hemorragia de tokens impide consolidar pilotos en producción. La barrera no es técnica ni humana; es financiera. Las organizaciones que ignoren la disciplina FinOps este trimestre se enfrentan a un ejercicio presupuestario de 2026 con números en rojo.
Este artículo explica cómo controlar ese gasto de forma estructural, no mediante recortes que matan la utilidad, sino rediseñando la arquitectura de consumo.
Por qué los LLMs sueltos son una hemorragia de tokens
Cuando una empresa despliega un agente sin arquitectura de memoria, cada conversación, cada consulta, cada tarea empieza desde cero. El modelo no recuerda nada. Para compensarlo, los equipos hacen lo único que saben hacer: meten más contexto en el prompt. Documentos enteros. Historiales completos. Instrucciones redundantes.
El resultado es un consumo de tokens que crece de forma cuadrática, no lineal. No porque los casos de uso sean más complejos, sino porque el sistema es estructuralmente ineficiente.
Esto tiene un nombre técnico en NextAI: Deuda de Contexto. La Deuda de Contexto es el sobrecoste en tokens que una organización paga por no tener memoria estructurada, y que se acumula silenciosamente en cada ejecución. Como la deuda técnica, no duele hasta que duele mucho.
La trampa del «funciona en el piloto»
En un piloto de cincuenta consultas al día, el gasto es invisible. Con quinientas consultas, empieza a notarse. Con cinco mil, el modelo de negocio se rompe. Las empresas que no diseñan para escala desde el principio acaban rediseñando bajo presión, con los costes ya disparados y los stakeholders ya impacientes.
FinOps para IA: qué es y qué no es
FinOps para IA no es ahorrar tokens a costa de calidad. No es usar modelos más baratos para todo sin criterio. Y no es poner un límite de gasto y esperar que el problema se resuelva solo.
FinOps para IA es la disciplina de gestionar el consumo de tokens como un recurso financiero crítico: con visibilidad, con atribución por proceso, con métricas de retorno y con arquitecturas diseñadas para optimizar el gasto sin degradar el resultado.
Sus tres pilares operativos son:
- Visibilidad: saber exactamente qué proceso consume qué tokens y cuánto cuesta cada ejecución.
- Atribución: asignar el gasto a casos de uso concretos para calcular el ROI real por proceso, no agregado.
- Optimización estructural: reducir el consumo rediseñando cómo los agentes acceden a la información, no recortando lo que hacen.
Si quieres entender cómo calcular el retorno antes de optimizar, este enfoque sobre el ROI de la IA te da el marco correcto para hacerlo sin trampas contables.
El RAO como termómetro financiero de tus agentes
La métrica más útil para conectar FinOps con operaciones es el RAO (Ratio de Autonomía Operativa): de cada 100 ejecuciones de un proceso, cuántas terminan sin intervención humana. Un RAO alto significa que el agente resuelve solo. Un RAO bajo significa que el humano corrige, reintenta o escala, y cada uno de esos eventos tiene un coste en tokens y en tiempo.
La relación entre RAO y coste por ejecución no es lineal. Un agente con RAO del 40 % no cuesta el doble que uno con RAO del 80 %. Cuesta mucho más, porque los reintentos generan contextos nuevos, las correcciones humanas añaden rondas de llamadas al modelo y la incertidumbre del sistema obliga a prompts más defensivos y más largos.
Un punto de mejora en el RAO no solo reduce intervenciones humanas: reduce el consumo de tokens por ejecución, porque un agente que confía en su contexto necesita menos palabras para llegar al resultado.
Tabla de impacto RAO sobre coste por proceso
| RAO estimado | Tokens medios por ejecución | Intervenciones humanas / 100 | Coste relativo |
|---|---|---|---|
| 30–40 % | 18.000–25.000 | 60–70 | Alto (base 100) |
| 50–60 % | 12.000–16.000 | 40–50 | Medio (55–70) |
| 75–85 % | 6.000–9.000 | 15–25 | Bajo (25–40) |
| 90 %+ | 3.500–5.500 | <10 | Muy bajo (<20) |
Rangos orientativos. El impacto real depende de la complejidad del proceso y del modelo utilizado.
Cómo un Cerebro Empresarial reduce el consumo estructuralmente
La palanca más potente de optimización de tokens no está en el modelo: está en la memoria. El Cerebro Empresarial de NextAI es la capa de memoria corporativa que combina RAG (Retrieval-Augmented Generation) con grafos de conocimiento para que los agentes accedan solo a la información relevante para cada consulta, no a documentos completos.
En la práctica, esto significa que en lugar de inyectar un manual de 80 páginas en el contexto, el agente recupera los tres fragmentos exactos que responden a la pregunta. El prompt pasa de 20.000 tokens a 2.000. La respuesta es igual de precisa o mejor, porque el ruido no contamina el razonamiento.
Comparativa: LLM suelto vs Cerebro Empresarial
| Dimensión | LLM sin memoria | Con Cerebro Empresarial |
|---|---|---|
| Contexto por consulta | Documento completo o historial | Fragmentos relevantes (RAG + grafos) |
| Tokens medios por consulta | 15.000–30.000 | 2.000–6.000 |
| Consistencia entre sesiones | Ninguna | Alta (memoria persistente) |
| Coste por 10.000 consultas | Base 100 | 15–40 % del base |
| RAO alcanzable | 30–50 % | 75–90 % |
| Deuda de Contexto | Creciente | Controlada |
El ahorro no es marginal. Es estructural. Y se compone: a medida que el grafo de conocimiento se enriquece, la precisión del retrieval mejora y el consumo de tokens baja más.
Este diseño es también la base de por qué la arquitectura modular protege frente al vendor lock-in: cuando la memoria es tuya, puedes cambiar el modelo subyacente sin reentrenar ni reconstruir el contexto.
El mapa de consumo: dónde mirar primero
Antes de optimizar, hay que medir. Y la mayoría de organizaciones no tienen visibilidad a nivel de proceso. Saben cuánto gastan en total. No saben qué proceso se lleva el 60 % del presupuesto.
Visualización: distribución típica del gasto en tokens por tipo de proceso
| Tipo de proceso | Consumo relativo | Barra |
|---|---|---|
| Generación de informes y resúmenes | 34 % | ███████░░░ |
| Atención y soporte interno | 28 % | █████░░░░░ |
| Análisis de documentos externos | 19 % | ████░░░░░░ |
| Automatización de flujos operativos | 12 % | ██░░░░░░░░ |
| Otros / experimentación | 7 % | █░░░░░░░░░ |
Leyenda: cada █ representa aproximadamente un 3–4 % del consumo total. Distribución orientativa basada en patrones frecuentes en implementaciones empresariales.
La generación de informes y resúmenes suele ser el mayor consumidor porque nadie ha cuestionado si el agente necesita leer el documento completo cada vez. Casi nunca lo necesita.
La Ruta NEXT-5 aplicada a FinOps
La Ruta NEXT-5 es la metodología de NextAI para construir ecosistemas de IA empresarial en cinco fases secuenciales: cartografía de procesos, construcción del Cerebro Empresarial, despliegue de Superagentes, orquestación multi-agente y gobierno. Desde una perspectiva FinOps, cada fase tiene un perfil de gasto distinto.
Las fases 1 y 2 (cartografía y cerebro) son inversión: se gasta en construir la memoria que va a ahorrar tokens en producción. Las fases 3 y 4 (agentes y orquestación) son donde el RAO empieza a generar retorno. La fase 5 (gobierno) es donde se institucionaliza el control financiero.
Las empresas que saltan directamente a la fase 3 sin haber construido el cerebro son las que acaban con el gasto descontrolado. No porque los agentes sean malos, sino porque operan sin memoria y replican la Deuda de Contexto en cada ejecución.
Si la decisión de construir vs comprar cada capa de este stack todavía está abierta en tu organización, este análisis sobre build vs buy en IA empresarial plantea los criterios correctos para tomarla sin sesgos tecnológicos.
Para el presupuesto de IA de 2026 en adelante, la transición de innovación a operaciones obliga a tratar el gasto en tokens como OPEX gestionable, no como gasto discrecional de I+D.
Preguntas frecuentes
¿Qué es FinOps para IA y en qué se diferencia del FinOps cloud?
FinOps para IA es la disciplina de gestionar el consumo de tokens como recurso financiero crítico, con visibilidad por proceso, atribución de costes y optimización estructural. Se diferencia del FinOps cloud en que el principal driver de coste no es la infraestructura, sino el diseño de los prompts y la arquitectura de memoria de los agentes.
¿Cómo se calcula el coste real de un agente de IA en producción?
El coste real incluye tokens de entrada y salida por ejecución, multiplicados por el precio del modelo, más el coste de las intervenciones humanas cuando el RAO es bajo. Un agente con RAO del 40 % puede costar tres o cuatro veces más por tarea resuelta que uno con RAO del 85 %, incluso usando el mismo modelo.
¿Cuánto puede reducirse el gasto en tokens con una arquitectura correcta?
Las organizaciones que pasan de LLMs sin memoria a un Cerebro Empresarial con RAG y grafos de conocimiento reducen el consumo de tokens entre un 60 % y un 85 % por consulta en procesos documentales. El rango depende del volumen de contexto que se eliminaba antes del retrieval estructurado.
¿Qué es el RAO y por qué es relevante para el presupuesto de IA?
El RAO (Ratio de Autonomía Operativa) mide cuántas ejecuciones de un proceso terminan sin intervención humana de cada 100. Es la métrica clave para el presupuesto porque un RAO bajo implica reintentos, correcciones y prompts adicionales: todos consumen tokens. Mejorar el RAO es simultáneamente mejorar la calidad operativa y reducir el coste unitario.
Qué hacer con esto
-
Audita tu consumo actual por proceso: antes de optimizar, necesitas saber qué proceso se lleva qué porcentaje del gasto en tokens. Sin atribución, no hay gestión posible.
-
Calcula el RAO de tus agentes en producción: si no tienes esta métrica, empieza a medirla esta semana. Es el indicador más directo de eficiencia económica de un agente.
-
Identifica tus tres mayores fuentes de Deuda de Contexto: qué procesos están inyectando documentos completos cuando podrían usar fragmentos. Ahí está el 70 % del ahorro potencial.
-
Prioriza la construcción del Cerebro Empresarial antes de escalar agentes: cada agente que despliegas sin memoria estructurada es una fuente nueva de Deuda de Contexto. La inversión en memoria se amortiza en las primeras semanas de producción.
-
Institucionaliza FinOps en la fase de gobierno de la Ruta NEXT-5: el control financiero del gasto en tokens no es una tarea puntual. Es un proceso continuo con dueño, métricas y revisión periódica.
Detectar la Deuda de Contexto acumulada y recuperar el RAO malgastado exige un diagnóstico técnico preciso. Proponemos una sesión de análisis técnico, sin propuestas comerciales ni argumentos de venta, para evaluar la eficiencia de su arquitectura. Solicite su Auditoría Digital y dedique 45 minutos a optimizar su consumo real de tokens.