Arquitectura de un agente de voz: Cascada STT-LLM-TTS vs Speech-to-Speech
Cascada STT-LLM-TTS o speech-to-speech: NextAI analiza cómo la latencia, el coste por minuto y el cumplimiento del AI Act definen el éxito de tus agentes de voz.

El 2026 arrancó con un dato que zanja, mediante números de producción y no de laboratorio, un debate enquistado en los comités de digitalización: la telemetría de DestiLabs sobre una decena de despliegues reales revela una mediana de latencia de 680 milisegundos y un coste de 0,07 a 0,21 dólares por minuto (DestiLabs, 2026 AI Voice Agent Benchmark). La interpretación de estas cifras trasciende lo técnico; es pura estrategia de negocio. La disyuntiva que hoy ocupa a las direcciones no versa sobre si la IA de voz funciona, sino sobre qué estructura sostener: la cascada STT-LLM-TTS, robusta y auditable, o el modelo speech-to-speech nativo, que sacrifica control por fluidez. Elegir mal no implica perder una funcionalidad, sino comprometer la operativa de miles de llamadas y tropezar con la normativa del AI Act. Desde NextAI, nuestra integración de estas tecnologías en los Cerebros Empresariales y nuestra posición como OpenAI Select Partner —detallada en nuestra entrada como Select Partner— nos permite contrastar la experiencia en el terreno con los benchmarks del sector para desglosar esta encrucijada.
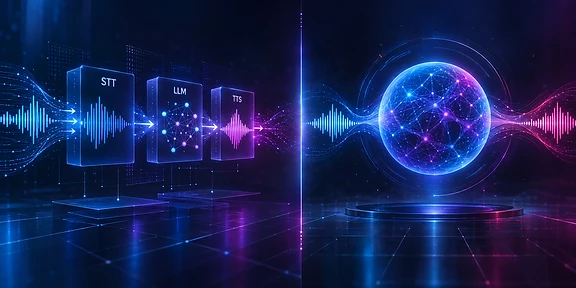
Cascada STT-LLM-TTS vs Speech-to-Speech: qué hay bajo el capó
Antes de discutir latencias o costes hay que fijar qué es cada cosa, porque el marketing del sector ha difuminado la frontera a propósito.
La cascada: tres modelos, un contrato de texto
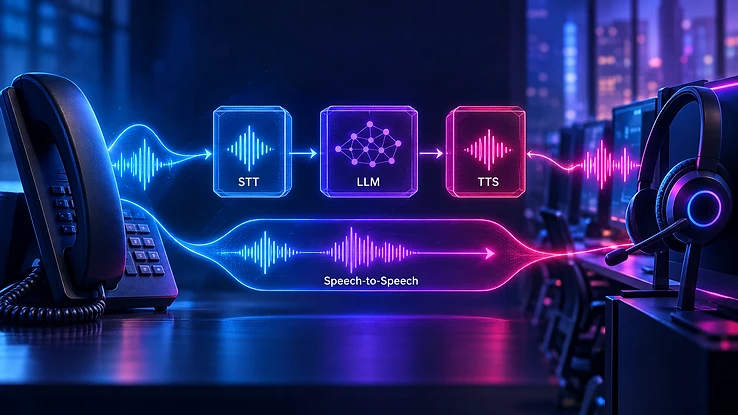
Una arquitectura en cascada concatena tres sistemas independientes —reconocimiento de voz (STT), un modelo de lenguaje (LLM) y síntesis de voz (TTS)— a través de una capa intermedia de texto. El audio entra, se transcribe, el texto se razona, el texto de salida se convierte de nuevo en audio. Es una tubería secuencial, pero cada tramo se puede sustituir, auditar y medir por separado.
El speech-to-speech nativo: un solo modelo, un bucle continuo
Los modelos speech-to-speech (S2S) end-to-end, como GPT-Realtime de OpenAI o Moshi de Kyutai, procesan directamente el flujo de audio de entrada y generan tokens de audio de salida sin pasar por una representación textual intermedia. No transcriben y luego hablan: escuchan y hablan en el mismo espacio latente. Esto elimina la pérdida paralingüística —entonación, risas, dudas, velocidad del habla— que la cascada sacrifica al reducirlo todo a texto plano, y gestiona de forma nativa la interrupción del usuario (barge-in) en un solo bucle continuo, sin las heurísticas rígidas de turno de palabra que exige la cascada.
El espejismo de la etiqueta "Speech-to-Speech"
Aquí conviene ser precisos, porque el dossier de nuestro laboratorio detecta una confusión activa en el mercado: algunos proveedores y plataformas de orquestación comercializan interfaces bajo el nombre "Speech-to-Speech" cuando, por debajo, siguen implementando una cascada empaquetada dentro de un único WebSocket. No es un engaño necesariamente malintencionado, pero sí una etiqueta que hay que verificar antes de firmar un contrato de infraestructura de voz, porque las implicaciones de gobernanza y de coste son radicalmente distintas según cuál sea la arquitectura real. Esto es exactamente el tipo de comprobación que recomendamos antes de contratar cualquier partner de IA —lo detallamos en cómo verificar a un partner de IA antes de contratarlo.
El presupuesto de latencia: la métrica que decide si el cliente cuelga
Por qué 800 milisegundos es la frontera que importa
Una conversación telefónica humana tiene un ritmo de turno de entre 200 y 500 milisegundos. Por encima de 800 milisegundos de latencia p50, el interlocutor empieza a notar fricción y a interrumpir; por encima de 1.200 milisegundos, la conversación se degrada de forma drástica y el cliente cuelga o repite la pregunta. Ese es el presupuesto de latencia con el que trabaja cualquier arquitectura de voz seria, sea cascada o nativa.
Una conversación de voz no se rompe cuando el modelo se equivoca. Se rompe cuando tarda.
Cómo la cascada compite en subsegundo
Durante años el argumento contra la cascada era su latencia acumulada: transcribir, razonar y sintetizar en serie suma los tiempos de cada tramo. Los análisis teóricos de comparación de componentes independientes siguen situando una cascada sin optimizar entre 1,5 y 3 segundos, por la suma secuencial de los suelos de latencia de cada modelo (Gradium, 2026 Architectural Guide). Pero eso es la cascada mal construida, no la cascada como concepto.
La cascada de producción competitiva en 2026 se sostiene sobre tres decisiones de ingeniería, no sobre un solo modelo mágico: streaming continuo vía WebSockets en lugar de peticiones por lotes, detección semántica de actividad de voz (VAD semántico) que evita cortar al usuario antes de que termine su idea, y síntesis TTS disparada con las primeras cláusulas del LLM en lugar de esperar la respuesta completa. Con esas tres piezas bien orquestadas, la telemetría de campo de DestiLabs sitúa la mediana en 680 ms y el percentil 95 en 1.180 ms, todavía dentro del umbral de conversación fluida.
| Métrica | Cascada optimizada | Speech-to-Speech nativo |
|---|---|---|
| Latencia p50 (extremo a extremo) | ~680 ms | Datos agregados en el mismo rango de flota |
| Latencia p95 | ~1.180 ms | Datos agregados en el mismo rango de flota |
| Coste all-in por minuto conectado | 0,07–0,13 $ | 0,18–0,21 $ |
| Tasa de contención de llamada | 62%–88% | 62%–88% |
Fuente: DestiLabs, Fleet Production Telemetry 2026, agregado sobre más de diez proyectos en producción.
La lectura empresarial de esta tabla es directa: en el terreno de la latencia percibida por el usuario, ambas arquitecturas ya compiten en el mismo rango cuando están bien construidas. La diferencia decisiva no está en la fluidez de la conversación, está en el coste y en el control, que veremos en el siguiente bloque.
Visualizando el presupuesto de latencia
Para que el comité de dirección entienda de un vistazo dónde se sitúa cada arquitectura respecto al umbral de 1.200 ms que marca la degradación de la conversación:
| Arquitectura / percentil | Latencia relativa al umbral de 1.200 ms |
|---|---|
| Cascada optimizada — p50 (680 ms) | █████░░░░░ 57 % |
| Cascada optimizada — p95 (1.180 ms) | █████████░ 98 % |
| Cascada sin optimizar (estimación teórica, 1,5–3 s) | ██████████ >100 % (fuera de umbral) |
Leyenda: cada barra representa el porcentaje de latencia consumido respecto al umbral de 1.200 ms a partir del cual la conversación se degrada de forma notable. El dato de cascada sin optimizar procede de comparativas teóricas de componentes, no de telemetría de producción, y se incluye para mostrar el margen de error de una implementación deficiente.
El mensaje para cualquier director de operaciones es este: la cascada no está condenada a la lentitud por diseño. Está condenada a la lentitud cuando se implementa sin streaming, sin VAD semántico y sin chunking temprano. La diferencia entre un pipeline de 680 ms y uno de 2,5 segundos no es la arquitectura, es la ingeniería que hay detrás de ella.
Sección técnica adicional: los componentes STT también compiten entre sí
Dentro de una cascada, el eslabón STT no es un bloque homogéneo. El proveedor de transcripción que elijáis determina buena parte del presupuesto de latencia total, y aquí los benchmarks de componentes muestran diferencias que un comité de dirección no debería ignorar.
| Motor STT | Time to First Token (TTFT) | Word Error Rate (WER) |
|---|---|---|
| Deepgram Nova-3 | ~992 ms (mediana) | No reportado en este benchmark |
| ElevenLabs Scribe v2 | ~2.080 ms (mediana) | No reportado en este benchmark |
| Universal-3.5 Pro Realtime | ~110 ms (p50) | 6,99 % general; 3,40 % en zona de paridad humana |
Fuente: Coval STT Benchmark 2026, vía Gradium y Pipecat Benchmark, vía AssemblyAI.
La diferencia entre 110 ms y 2.080 ms de TTFT no es un matiz técnico, es la diferencia entre encajar en el presupuesto de latencia subsegundo o quemarlo entero solo con la transcripción, antes de que el LLM haya empezado siquiera a razonar. Elegir el motor STT dentro de una cascada no es una decisión de catálogo, es una decisión de arquitectura: un motor rápido pero con más error obliga a compensar con guardrails de validación aguas abajo; un motor con menor WER pero más lento obliga a comprimir el presupuesto de latencia en el tramo LLM y TTS. La modularidad de la cascada permite precisamente esto: pelear cada tramo por separado y sustituir el componente que no rinde, algo que un modelo S2S monolítico no permite.
Economía de la voz: coste total de la propiedad
El coste de un agente de voz no es el precio por minuto que aparece en la landing del proveedor. Es la suma de telefonía (SIP trunking), transcripción, tokens de razonamiento del LLM, caracteres de síntesis TTS y la capa de middleware que orquesta todo el streaming. Presupuestar solo con el precio de inferencia es el error de bulto más habitual que vemos en los comités que están migrando su centralita.
| Modelo | Precio input audio | Precio output audio |
|---|---|---|
| gpt-realtime-2.1 | 32 $ / millón de tokens | 64 $ / millón de tokens |
| gpt-realtime-2.1-mini | 10 $ / millón de tokens | 20 $ / millón de tokens |
Fuente: Inworld, OpenAI Realtime API Pricing Benchmark.
La cascada permite algo que el S2S monolítico no permite con la misma facilidad: enrutamiento inteligente. Una consulta repetitiva —horario de apertura, estado de un pedido, cambio de cita— no necesita el modelo de razonamiento más caro del catálogo. Enviarla a un LLM ligero dentro del tramo de texto de la cascada reduce el gasto de razonamiento entre un 40 % y un 60 %, según la telemetría de flota de DestiLabs, sin mermar la tasa de contención de llamada, que se mantiene en el rango del 62 %-88 % independientemente de la arquitectura.
Aquí es donde entra un concepto propietario de NextAI: el RAO, Ratio de Autonomía Operativa, que mide de cada 100 ejecuciones de un proceso —en este caso, 100 llamadas— cuántas terminan sin intervención humana. Un agente de voz con RAO alto y coste por minuto bajo es rentable de forma estructural; un agente con RAO alto pero coste por minuto de S2S nativo puede seguir sin justificarse si el volumen de llamadas es alto y la interacción no requiere matiz emocional. El cálculo completo de este trade-off, con cifras de coste de agente humano frente a agente de voz IA, lo desarrollamos en nuestro modelo TCO 2026.
El sobrecoste del S2S nativo se justifica en un número acotado de escenarios: interacciones VIP donde la prosodia forma parte de la propuesta de valor, conserjería de alta gama, o venta consultiva donde la empatía vocal percibida impulsa directamente la conversión. Fuera de esos casos, pagar entre 0,18 y 0,21 dólares por minuto por naturalidad paralingüística en una consulta de horario de apertura es quemar margen sin retorno.
Riesgo, seguridad y gobernanza: el texto intermedio como firewall
La ventaja menos discutida de la cascada, y la más relevante bajo el AI Act y el RGPD, es que el texto intermedio actúa como cortafuegos transaccional. Entre la transcripción y la síntesis hay un punto determinista donde se puede insertar enmascarado de datos personales (PII masking), guardrails semánticos y validación de esquema JSON antes de que ninguna acción toque el ERP o el CRM. Esa capa es auditable, versionable y exportable a un log de cumplimiento.
Un modelo speech-to-speech nativo, por diseño, no ofrece ese punto de intercepción: el audio entra y el audio sale, sin una representación intermedia donde interceptar una inyección de instrucciones por audio o una deriva alucinatoria antes de que provoque una acción real. Auditar una caja negra de este tipo bajo los requisitos de trazabilidad del Reglamento Europeo de IA es, hoy, sustancialmente más complejo que auditar una cascada con texto intermedio.
Esta capa de texto es también el punto donde conectamos la voz con el Cerebro Empresarial: la memoria corporativa construida con RAG y grafos de conocimiento que da a cada respuesta contexto real sobre el cliente, el pedido o la póliza, en lugar de una respuesta genérica generada en el vacío. Y es el punto donde un Superagente —un agente que se hace cargo de un proceso completo, no de una sola respuesta— puede ejecutar el ciclo entero de una llamada: verificar identidad, consultar el estado del pedido, aplicar la política de devolución y confirmar la acción en el sistema corporativo, todo con trazabilidad completa.
Antes de decidir cuánta autonomía dar a la voz, conviene medir en qué punto de madurez está realmente la empresa. Ahí es donde entra el IMAN, el Índice de Madurez AI-Native de NextAI, y en concreto su eje de gobierno: una empresa con un eje de gobierno débil no debería desplegar S2S nativo en procesos transaccionales sensibles, por muy natural que suene la voz.
Operación real en empresas españolas migrando centralitas
La teoría de latencias y costes se enfrenta, sobre el terreno, a dos problemas muy concretos en España: la integración SIP/WebRTC con la latencia de red local añadida, y el soporte real de los acentos y variantes regionales del castellano. Los modelos speech-to-speech nativos están entrenados y optimizados de forma mayoritaria sobre inglés norteamericano, y el rendimiento en español peninsular o en acentos regionales todavía no es homogéneo entre proveedores.
La cascada resuelve esto con modularidad: permite combinar el mejor transcriptor en español disponible en el mercado con una voz sintética clonada de la marca corporativa, manteniendo la soberanía sobre los datos y reduciendo el riesgo de bloqueo de proveedor. Esa capacidad de mezclar y sustituir componentes es, precisamente, lo que un integrador serio debería aportar y lo que diferencia a un partner de un simple revendedor de licencias, como explicamos en partner de IA o proveedor de licencias.
La estrategia que vemos funcionar en despliegues reales es crawl-walk-run: cascada como estándar operativo para el 80-90 % de las llamadas rutinarias —consultas, gestiones transaccionales, agendas—, reservando el speech-to-speech nativo para el 10-20 % restante donde la fidelidad emocional realmente mueve la aguja del negocio.
Qué significa para tu empresa
La decisión no es ideológica, es de encaje. Un contact center transaccional de alto volumen —bancario, seguros, logística— debería construir sobre cascada: control de coste, auditoría completa y tool calling robusto. Una operación de venta consultiva de alto valor o conserjería premium puede justificar S2S nativo en un subconjunto acotado de llamadas. Una empresa con fuerte presencia multiacento regional necesita la modularidad de la cascada para no depender de un modelo sesgado hacia el inglés. Y cualquier empresa con requisitos estrictos de compliance —sanidad, banca, seguros— necesita el firewall transaccional de texto intermedio como condición no negociable.
Los criterios de decisión, en orden de peso:
- Volumen de llamadas mensual: a mayor volumen, mayor impacto del coste por minuto en el resultado.
- Sensibilidad de los datos tratados: a mayor sensibilidad, mayor necesidad de firewall de texto intermedio.
- Necesidad de tool calling estructurado contra ERP/CRM: si existe, la cascada es la opción por defecto.
- Presupuesto de latencia real del proceso: si el proceso tolera hasta 1.200 ms p95, la cascada optimizada compite sin problema.
- Madurez del eje de gobierno según el IMAN: sin un gobierno maduro, ninguna arquitectura debería operar con autonomía plena.
Metodología y fuentes
El laboratorio de NextAI ha cruzado tres capas de evidencia: telemetría de producción sobre despliegues reales, benchmarks independientes de componentes STT y TTS, y el pricing público de los modelos S2S, contrastando todo ello con nuestra propia experiencia de integración como OpenAI Select Partner en proyectos de migración de centralitas en España. Las fuentes externas consultadas son DestiLabs, Inworld, Gradium y AssemblyAI.
Preguntas frecuentes
¿Es el speech-to-speech nativo mejor que la cascada STT-LLM-TTS?
No de forma absoluta. El S2S nativo gana en naturalidad paralingüística y gestión de interrupciones; la cascada gana en coste, control transaccional y facilidad de auditoría. La telemetría de producción muestra latencias similares en ambas cuando la cascada está bien optimizada, así que la elección depende del caso de uso, no de una superioridad técnica general.
¿Cuánto cuesta realmente un agente de voz IA por minuto?
Según telemetría de flota en producción, entre 0,07 y 0,21 dólares por minuto conectado, todo incluido: telefonía, STT, tokens de LLM y TTS. La cascada se sitúa en el tramo bajo (0,07-0,13 $) y el speech-to-speech nativo en el tramo alto (0,18-0,21 $). El precio publicitario de un solo componente nunca refleja el coste real de la operación completa.
¿Puede una cascada alcanzar latencia subsegundo en español?
Sí, cuando se construye con streaming vía WebSockets, detección semántica de actividad de voz y síntesis TTS disparada con las primeras cláusulas del LLM. La telemetría de producción sitúa la mediana en torno a 680 ms. Sin esa ingeniería, una cascada puede degradarse hasta 1,5-3 segundos, un rango que sí resulta perceptible para el usuario.
¿Es seguro un agente de voz S2S nativo bajo el AI Act y el RGPD?
Es más difícil de auditar porque no tiene un paso de texto intermedio determinista donde interceptar PII, validar esquemas o filtrar inyecciones de instrucciones por audio. La cascada ofrece ese firewall transaccional de forma nativa. Un despliegue S2S en procesos sensibles exige controles adicionales que compensen esa opacidad estructural.
Qué hacer con esto
El éxito en la transición de las centralitas PBX hacia la IA conversacional depende de un criterio técnico riguroso. Primero, audita el coste all-in real, sumando SIP trunking, tokens y latencias, más allá de los precios de catálogo. Segundo, impón un SLA de latencia p95 bajo los 1.200 milisegundos. Tercero, instala un firewall de gobernanza en la capa intermedia para filtrar toda comunicación antes de tocar sistemas transaccionales. Cuarto, monitoriza el RAO, ignorando la subjetividad de la satisfacción. Por último, confina el speech-to-speech a interacciones donde la prosodia eleve la conversión, reservando la arquitectura modular para el grueso de la operación. Pide tu Auditoría Digital para analizar la viabilidad de tu infraestructura actual en 45 minutos.