ServiceNow AutoSynthData: Datos sintéticos para agentes IA
ServiceNow lanza AutoSynthData, un framework open source para generar datos sintéticos y entrenar agentes corporativos sin exponer PII. Analizamos su alcance real.
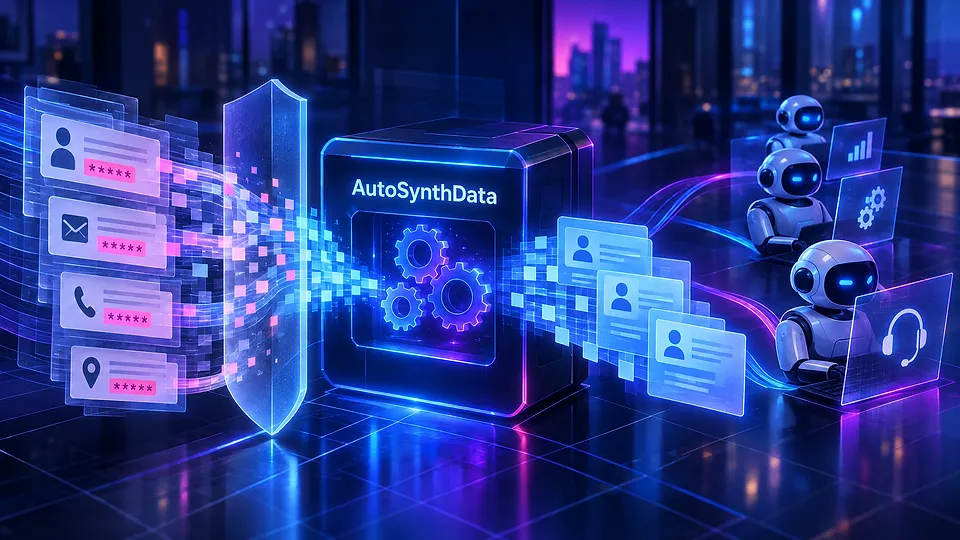

ServiceNow ha resuelto, al menos parcialmente, uno de los obstáculos que más retrasa la llegada de agentes autónomos a las empresas: la falta de datos reales con los que entrenarlos. No es un detalle técnico menor. Ayuda a explicar por qué la mayoría de los proyectos de IA agéntica en España siguen atascados en fase piloto, consumiendo presupuesto sin liberar a un solo empleado de tareas repetitivas.
El 18 de noviembre, ServiceNow-AI publicó en Hugging Face el framework AutoSynthData, diseñado específicamente para generar datos sintéticos de entrenamiento para agentes corporativos. No es otro modelo fundacional más, sino una pieza de infraestructura que ataca el cuello de botella real: la falta de trazas operativas limpias, verificables y legalmente seguras para hacer ajuste fino (SFT) de agentes que ejecutan procesos de negocio.
La tesis que NextAI viene señalando desde hace meses es clara: el problema ya no es cuánto razona un modelo, sino cuánto contexto corporativo verificado tiene para actuar. A esa carencia la llamamos Deuda de Contexto: la brecha acumulada entre lo que una empresa necesita que su IA sepa sobre sus procesos reales y lo que realmente le ha enseñado. AutoSynthData es la primera solución open source seria que ataca esa deuda sin obligarte a exponer datos de clientes o empleados.
Qué es AutoSynthData y qué cambia exactamente
Los hechos, antes que la interpretación. ServiceNow, a través de sus equipos ServiceNow CoreAI y ServiceNow-AI, ha publicado un framework que genera datos sintéticos orientados al entrenamiento de agentes de IA corporativos. La documentación técnica y el anuncio se difundieron en el repositorio y blog de ServiceNow-AI en Hugging Face, acompañados del entorno de evaluación asociado, ServiceNow-AI/EnterpriseOps-Gym Hugging Face Blog - ServiceNow-AI.
El framework se centra en resolver tres problemas muy concretos que cualquier equipo que haya intentado entrenar un agente reconocerá de inmediato:
- El arranque en frío: no hay trazas de ejecución previas porque el proceso nunca se ha automatizado.
- La cobertura de casos de cola larga: los escenarios raros, que son precisamente los que rompen a un agente en producción, casi nunca están documentados.
- La escasez de trazas de fallo: la mayoría de los registros capturan éxitos, no los caminos de recuperación tras un error, que es justo lo que un agente necesita aprender para ser fiable.
Esto no es una afirmación de marketing de ServiceNow. Es la descripción técnica del problema que el propio framework declara atacar, según consta en la documentación publicada.
Lo que todavía no está confirmado
Aquí conviene ser riguroso, porque la tentación de simplificar es alta. La documentación inicial en Hugging Face y las notas de análisis disponibles no detallan explícitamente la licencia de código abierto exacta de AutoSynthData, ni el coste computacional o financiero por millón de tokens generados sintéticamente. Tampoco queda del todo claro, en las fuentes consultadas, dónde termina AutoSynthData como framework de investigación agéntica y dónde empiezan las capacidades comerciales ya existentes en Now Assist Data Kit, impulsadas por NowLLM dentro de la plataforma propietaria de ServiceNow ServiceNow Official Knowledge Base. Si tu equipo legal o técnico va a evaluar esto, pide confirmación explícita de licencia antes de comprometer recursos.
El dato que importa: de 18,77 % a 27,18 % de éxito
Aquí está el número que justifica el interés. En el entorno de evaluación EnterpriseOps-Gym, orientado a tareas de gestión de servicios de TI (ITSM), aplicar ajuste fino supervisado con datos generados por AutoSynthData eleva la tasa media de éxito en ejecución de tareas (Pass@1) del 18,77 % al 27,18 % Hugging Face Blog - ServiceNow-AI.
Traducido a negocio: de cada 100 tickets o procesos que un agente intenta resolver de forma autónoma, antes del ajuste fino solo completaba correctamente unos 19; después, completa cerca de 27. Es una mejora relativa superior al 44 %, lograda sin tocar el modelo base, solo cambiando los datos de entrenamiento.
| Métrica | Antes de SFT con AutoSynthData | Después de SFT con AutoSynthData |
|---|---|---|
| Tasa de éxito Pass@1 (ITSM) | 18,77 % | 27,18 % |
| Mejora relativa | — | +44,8 % aprox. |
| Fuente de los datos de entrenamiento | Trazas reales limitadas | Trazas sintéticas verificadas |
Para visualizar la magnitud del salto, así se comporta el indicador en el benchmark EnterpriseOps-Gym:
| Escenario | Pass@1 | Representación |
|---|---|---|
| Sin ajuste fino | 18,77 % | ███▊░░░░░░ 18,8 % |
| Con SFT + AutoSynthData | 27,18 % | █████▍░░░░ 27,2 % |
Leyenda: cada bloque █ representa aproximadamente un 5 % de tasa de éxito sobre el total de 100 ejecuciones evaluadas en el benchmark ITSM de EnterpriseOps-Gym.
Este tipo de salto es exactamente el que mueve el RAO de un proceso. El Ratio de Autonomía Operativa mide, de cada 100 ejecuciones de un proceso, cuántas terminan sin intervención humana; un agente que pasa de resolver 19 a 27 de cada 100 casos de forma autónoma está moviendo directamente ese ratio hacia arriba, con todo lo que implica en coste de soporte de primer nivel.
Por qué el razonamiento ya no es el problema
Durante dos años, la conversación sobre IA empresarial giró en torno al tamaño y la potencia de los modelos fundacionales. Esa conversación ha caducado. Los modelos actuales, incluso los de tamaño medio, razonan sobradamente bien para la mayoría de procesos operativos. El problema nunca estuvo ahí.
El cuello de botella de la IA agéntica ha dejado de ser el razonamiento puro del LLM para convertirse en la disponibilidad de datos de trayectoria fiables.
Esto conecta directamente con la arquitectura de lo que en NextAI llamamos Cerebro Empresarial: una memoria corporativa construida sobre RAG y grafos de conocimiento que no solo almacena documentos, sino que captura cómo se ejecutan realmente los procesos, incluidos los fallos y las excepciones. Sin esa memoria viva, cualquier Superagente que despliegues —un agente que se hace cargo de un proceso completo, no de una tarea suelta— improvisará sobre escenarios que nunca ha visto, con el coste de error que eso implica en producción.
AutoSynthData ataca precisamente esa carencia desde el lado de los datos de entrenamiento, no desde el modelo. Y lo hace con una aproximación técnica que merece revisión detallada antes de decidir si aplica a tu caso.
Cómo genera las trayectorias sintéticas
Según el análisis técnico disponible, AutoSynthData no genera texto suelto ni pares de pregunta-respuesta simples. Simula trayectorias completas de agente: razonamiento paso a paso, selección de herramientas operativas —APIs, CMDB, scripts internos— y validación de precondiciones y postcondiciones antes y después de cada acción OpenAI Hub / Tech News Aggregator.
Esto importa por una razón muy concreta. La mayoría de los datasets de entrenamiento reales están sesgados hacia los caminos de éxito trivial, porque nadie documenta minuciosamente cómo se recupera un técnico cuando una API falla a mitad de proceso. AutoSynthData, al modelar interacciones sintéticas estructuradas, inyecta deliberadamente trazas de error y recuperación, mitigando ese sesgo. Es la diferencia entre un agente que funciona en la demo y uno que sobrevive al tercer incidente real de producción.
Si te interesa cómo se están resolviendo problemas de interoperabilidad similares en el ecosistema de agentes, conviene revisar también cómo compiten los protocolos de comunicación entre agentes, un debate que detallamos en MCP vs A2A: Guía de protocolos agénticos para directivos, porque datos sintéticos de calidad y protocolos de coordinación robustos son las dos caras de la misma moneda operativa.
El impacto económico: menos meses, menos coste humano
Capturar y anotar manualmente miles de trazas operativas reales de un servicio de Helpdesk o un CRM no es barato ni rápido. Implica equipos dedicados, revisión legal de cada traza para eliminar información sensible, y típicamente meses de retardo antes de tener un dataset mínimamente útil para ajuste fino.
El uso de datos sintéticos cambia esa ecuación de forma radical. Reduce el tiempo de despliegue de agentes especializados porque elimina la fase de recolección pasiva de datos reales, que es con diferencia la más lenta del proceso. Y mejora el retorno de la inversión por una vía poco intuitiva: permite que modelos de tamaño más modesto alcancen un rendimiento operativo similar al de modelos frontera, simplemente porque están mejor entrenados para el proceso específico que deben ejecutar, no porque sean más grandes o más caros de operar.
Esto tiene una implicación directa para cualquier empresa mediana que no pueda permitirse una factura mensual de tokens de un modelo propietario de última generación: ajustar un modelo local u on-premise con datos de proceso sintéticos reduce tanto la dependencia de APIs externas como el coste recurrente asociado.
Riesgo, seguridad y gobierno: RGPD y AI Act
Aquí está la ventaja regulatoria que explica por qué este lanzamiento interesa tanto en Europa como en Estados Unidos. Si los datos de entrenamiento son 100 % sintéticos, no hay información personal real de clientes ni empleados que proteger. Eso reduce de forma directa la exposición ante el RGPD y, en España, las contingencias frente a la AEPD: no puedes filtrar lo que nunca tuviste en tus logs de entrenamiento.
Pero el matiz importa tanto como la ventaja, y conviene no simplificarlo en una diapositiva de ventas. El Reglamento Europeo de IA (AI Act) clasifica muchos sistemas de automatización de procesos operativos como de riesgo limitado o alto según el sector, y esos sistemas exigen auditorías de representatividad. Un dataset sintético mal calibrado puede amplificar alucinaciones o sesgos existentes en el modelo generador, en lugar de corregirlos. Si entrenas un agente de soporte IT con trayectorias sintéticas que sobrerrepresentan ciertos tipos de incidencia y subrepresentan otros, el agente heredará ese desequilibrio en producción, con usuarios reales pagando el coste del error.
La respuesta no es rechazar los datos sintéticos. Es no desplegarlos sin validación humana continua. El Human-in-the-Loop deja de ser una frase de compliance y se convierte en un mecanismo operativo: alguien debe muestrear periódicamente las decisiones del agente entrenado con AutoSynthData y comparar su comportamiento con casos reales, antes de ampliar su alcance.
Esto encaja de forma directa con uno de los cinco ejes del IMAN (Índice de Madurez AI-Native), el marco con el que en NextAI diagnosticamos cuánto preparada está una empresa para operar con IA agéntica: el eje de gobierno mide precisamente si existen mecanismos de auditoría y supervisión como este antes de escalar un sistema autónomo. Un agente entrenado con datos sintéticos sin ese eje de gobierno maduro no es un activo, es un pasivo legal en espera de materializarse. Dentro de la Ruta NEXT-5 —el itinerario que seguimos en NextAI para construir ecosistemas de IA empresarial en cinco fases: cartografía, cerebro, superagentes, orquestación y gobierno— AutoSynthData encaja en la fase de cerebro, alimentando de contexto a la memoria corporativa, pero su despliegue responsable depende de que la fase de gobierno ya esté activa, no sea una ocurrencia tardía.
| Dimensión | Datos reales de producción | Datos sintéticos (tipo AutoSynthData) |
|---|---|---|
| Exposición de PII | Alta, requiere anonimización costosa | Prácticamente nula si el proceso es correcto |
| Velocidad de despliegue | Lenta, meses de recolección y limpieza | Rápida, generación dirigida en días o semanas |
| Cumplimiento AI Act (alto riesgo) | Requiere auditoría de origen de datos | Requiere auditoría de representatividad sintética |
| Riesgo de sesgo | Hereda sesgos históricos reales | Puede amplificar sesgos del modelo generador si no se valida |
Ninguna columna gana en todo. Esa es la lectura correcta de la tabla: los datos sintéticos resuelven el problema de privacidad y velocidad, pero trasladan el problema de sesgo a un punto distinto del proceso, uno que exige validación activa en lugar de anonimización pasiva.
Operación real en empresas españolas
La mayoría de las medianas empresas españolas con las que trabajamos no tienen un problema de modelos. Tienen un problema de telemetría. No existen registros limpios de cómo se resolvió cada incidencia de soporte en los últimos tres años, porque nunca se diseñó el sistema para capturarlo con ese propósito. Eso convierte el entrenamiento de un agente corporativo clásico en un proyecto de meses solo para reunir el dataset mínimo viable.
Aquí es donde frameworks como AutoSynthData cambian la ecuación de entrada para este segmento concreto. Permiten hacer un "bootstrap" de agentes de soporte o backoffice sin necesitar ese almacén histórico previo, generando trayectorias sintéticas representativas del proceso desde el primer día. Baja la barrera técnica justo donde más duele: en la empresa de 80 a 300 empleados que quiere automatizar su mesa de ayuda IT pero no tiene presupuesto para un proyecto de recolección de datos de seis meses.
Este movimiento hacia infraestructura abierta y reproducible no es un caso aislado. Ya lo vimos con el enfoque de transparencia total en entrenamiento que analizamos en OLMo-core de AllenAI: Infraestructura Abierta y MoE, y se repite en la tensión entre pesos abiertos y modelos cerrados que planteamos al estudiar Mistral AI Serie D: ¿pesos abiertos o modelos cerrados en la UE?. La disponibilidad de herramientas abiertas para generar y ajustar modelos reduce la dependencia de proveedores únicos, algo especialmente relevante para una pyme española que no quiere atarse a un contrato de API propietaria sin capacidad de negociación.
Piensa en un caso concreto: una empresa de servicios con 150 empleados despliega un Superagente de soporte IT de primer nivel, entrenado con trazas sintéticas tipo AutoSynthData sobre sus propios procesos documentados. Si el RAO de ese proceso pasa de 20 a 30 de cada 100 tickets resueltos sin intervención humana, el equipo de soporte no desaparece, pero se libera para atender exactamente los casos complejos que antes no tenía tiempo de resolver bien. Esa es la métrica que debería importarte, no cuántos parámetros tiene el modelo subyacente.
Qué significa para tu empresa
La respuesta correcta depende de dónde estés, no de qué titular hayas leído.
- Pyme sin datos históricos de proceso: es tu caso de uso más claro. Usa un enfoque de datos sintéticos para arrancar un agente de soporte en un proceso de bajo riesgo —gestión de tickets internos, por ejemplo— antes de tocar nada que afecte a clientes finales.
- Empresa mediana con compliance estricto (banca, salud, seguros): prioriza la auditoría de representatividad antes de cualquier ajuste fino con datos sintéticos, y espera confirmación explícita de licencia y trazabilidad del framework antes de comprometer presupuesto. Aquí la prisa sale cara.
- Gran corporación con Cerebro Empresarial ya maduro: integra los datos sintéticos como complemento de las trazas reales que ya capturas, nunca como sustituto. El valor está en cubrir los casos de cola larga que tu propia operación aún no ha generado, no en reemplazar la memoria corporativa existente.
| Criterio de decisión | Peso en la decisión |
|---|---|
| Madurez de datos propios (eje "datos" del IMAN) | Alto: si ya tienes trazas limpias, prioriza combinarlas |
| Criticidad regulatoria del proceso | Alto: a mayor riesgo, más auditoría previa necesaria |
| Presupuesto de cómputo disponible | Medio: condiciona si entrenas modelo propio u on-premise |
Antes de adoptar cualquier enfoque de datos sintéticos, haz el ejercicio honesto de autoevaluarte con el IMAN. Si tu eje de gobierno está por debajo de tu eje de agencia, estás a punto de desplegar un agente más rápido de lo que puedes auditarlo, y eso rara vez termina bien.
Metodología y fuentes
El laboratorio NextAI ha cruzado el anuncio técnico publicado por ServiceNow-AI con el benchmark EnterpriseOps-Gym y con el marco regulatorio europeo vigente, separando en todo momento lo que la documentación confirma de lo que aún está pendiente de aclarar, como la licencia exacta o el coste por token. No hemos replicado el entrenamiento ni verificado de forma independiente la metodología de generación; nuestro análisis se apoya en las fuentes públicas disponibles y en nuestra experiencia desplegando agentes corporativos en empresas españolas.
Fuentes consultadas: Hugging Face Blog - ServiceNow-AI, OpenAI Hub / Tech News Aggregator, Hyper.ai Stories y ServiceNow Official Knowledge Base.
Preguntas frecuentes
¿Qué es ServiceNow AutoSynthData exactamente?
Es un framework publicado por ServiceNow-AI en Hugging Face que genera datos sintéticos —trayectorias completas de razonamiento, uso de herramientas y recuperación de errores— para entrenar y ajustar agentes de IA corporativos, especialmente en escenarios de arranque en frío y casos de cola larga donde faltan datos reales.
¿Es seguro usar datos sintéticos para entrenar agentes en empresas europeas (RGPD/AI Act)?
Reduce significativamente la exposición de datos personales reales bajo el RGPD, pero no exime de las obligaciones del AI Act en sistemas de alto riesgo, que exigen auditorías de representatividad para evitar que el dataset sintético amplifique sesgos o alucinaciones del modelo generador.
¿Sustituye AutoSynthData a los datos reales de mi empresa?
No, según la propia naturaleza del framework. Funciona mejor como complemento que cubre huecos —casos raros, trazas de fallo— que tus datos reales no capturan, no como reemplazo total de la memoria operativa real que alimenta tu Cerebro Empresarial.
¿Qué tamaño de empresa puede beneficiarse ya de este enfoque?
Las pymes sin telemetría madura son las que más ganan a corto plazo, porque elimina meses de recolección pasiva de datos. Las grandes corporaciones con compliance estricto deben esperar mayor claridad sobre licencia y validación antes de escalarlo a procesos críticos.
Qué hacer con esto
La adopción de AutoSynthData exige avanzar con método y sin confundir datos sintéticos con ausencia de riesgo:
- Audita qué procesos operativos de tu empresa carecen de trazas reales suficientes para entrenar un agente y clasifícalos por nivel de riesgo regulatorio.
- Evalúa tu madurez actual con el IMAN, prestando especial atención al eje de gobierno antes de considerar cualquier despliegue de agentes entrenados con datos sintéticos.
- Pilota el enfoque en un proceso de bajo riesgo —soporte interno, no atención directa a clientes— antes de tocar nada sensible.
- Establece desde el primer día un mecanismo de validación humana periódica sobre las decisiones del agente: no como control puntual, sino como proceso continuo.
- Si tu equipo legal va a evaluar AutoSynthData u otra herramienta similar, exige confirmación explícita de la licencia y de las condiciones de uso antes de comprometer presupuesto de cómputo o calendario de proyecto.
Pide tu Auditoría Digital — 45 minutos, sin presentación comercial.